
Dejaron a una IA sola en una isla virtual y pasó algo inesperado
17 de octubre de 2026

Parece que la vida tiene una inclinación natural por el juego. Cualquiera que haya pasado diez minutos con un niño de cinco años lo sabe perfectamente: los más pequeños son auténticos maestros a la hora de inventar mundos imaginarios. Y no es algo exclusivo de los humanos. El juego surge de manera instintiva en todo el reino animal. A las ratas les encanta jugar a pelearse, especialmente después de pasar un tiempo aisladas. Los pulpos manipulan piezas de Lego de una forma muy parecida a como un bebé juega con bloques de construcción.
Lejos de ser una pérdida de tiempo, el juego parece constituir un mecanismo fundamental de interacción y aprendizaje entre los individuos y el mundo exterior. Es una especie de investigación informal sobre las reglas básicas que gobiernan los entornos físicos y sociales. Como señaló en una ocasión la Academia Estadounidense de Pediatría: «El juego y el aprendizaje están inseparablemente unidos».
Las máquinas son diferentes. Están diseñadas para seguir reglas estrictas, fórmulas e instrucciones algorítmicas. Es cierto que los sistemas modernos de inteligencia artificial se distinguen de otras máquinas por su capacidad de aprender con el tiempo, al menos en un sentido limitado. Sin embargo, el aprendizaje automático sigue siendo, en esencia, un proceso dirigido desde arriba: los modelos de IA se entrenan para alcanzar determinados objetivos (las llamadas «funciones objetivo», en la jerga tecnológica), se evalúa su rendimiento y, a partir de esos resultados, ajustan sus estrategias. Pero tanto los objetivos como los criterios que determinan el éxito o el fracaso los establecen los seres humanos.
Esto plantea una pregunta interesante: ¿qué ocurriría si permitiéramos que un sistema de inteligencia artificial aprendiera por sí mismo desde cero? Décadas de investigaciones en psicología del desarrollo han demostrado que los niños pequeños y otros animales aprenden sobre el mundo interactuando activamente con él, principalmente a través del juego. ¿Sería posible reproducir ese tipo de aprendizaje en una IA?
Náufragos de la IA
Eso es precisamente lo que un equipo de investigadores del Laboratorio de Ciencias de la Computación e Inteligencia Artificial del MIT (CSAIL) se propuso investigar en un estudio reciente. Su planteamiento era sorprendentemente sencillo: dejar a un agente de inteligencia artificial solo en un entorno virtual delimitado y observar qué sucedía.
Cualquiera podría imaginar que el agente simplemente se quedaría inmóvil o empezaría a chocarse contra las paredes como un personaje no jugable de un videojuego. Sin embargo, la realidad resultó mucho más sorprendente.
El agente, bautizado como Eko, funcionaba con Claude Code, lo que significa que ya disponía de una enorme cantidad de conocimientos semánticos. Pero, a diferencia del Claude convencional, Eko también recibió un cuerpo virtual: el de una langosta, probablemente como guiño al agente anteriormente conocido como Clawdbot.
Podía ofrecer respuestas detalladas a prácticamente cualquier pregunta científica o matemática, pero cuando se trataba de desplazarse por su entorno y manipular objetos, era tan inexperto como un recién nacido.
El objetivo del estudio consistía en dar libertad a Eko y observar si era capaz de descubrir las reglas fundamentales de su entorno sin recibir instrucciones explícitas. En total, los investigadores observaron a trece instancias diferentes de Eko, a las que permitieron recorrer la isla durante 30 horas ininterrumpidas.
Como etólogos que contemplan a un animal desconocido correteando por un recinto, los científicos se limitaron a observar.
«Nuestra idea era imponer el menor número posible de restricciones, porque queríamos ver realmente cómo se comportan estos agentes autónomos cuando no les dices qué tienen que hacer», explicó Nathan Cloos, estudiante de doctorado del MIT y uno de los coautores del estudio.
Sería algo así como aparcar un coche autónomo junto a una carretera de Londres y dejar que descubriera por sí solo las normas de circulación, aunque sin las inevitables víctimas y los daños materiales que semejante experimento provocaría.
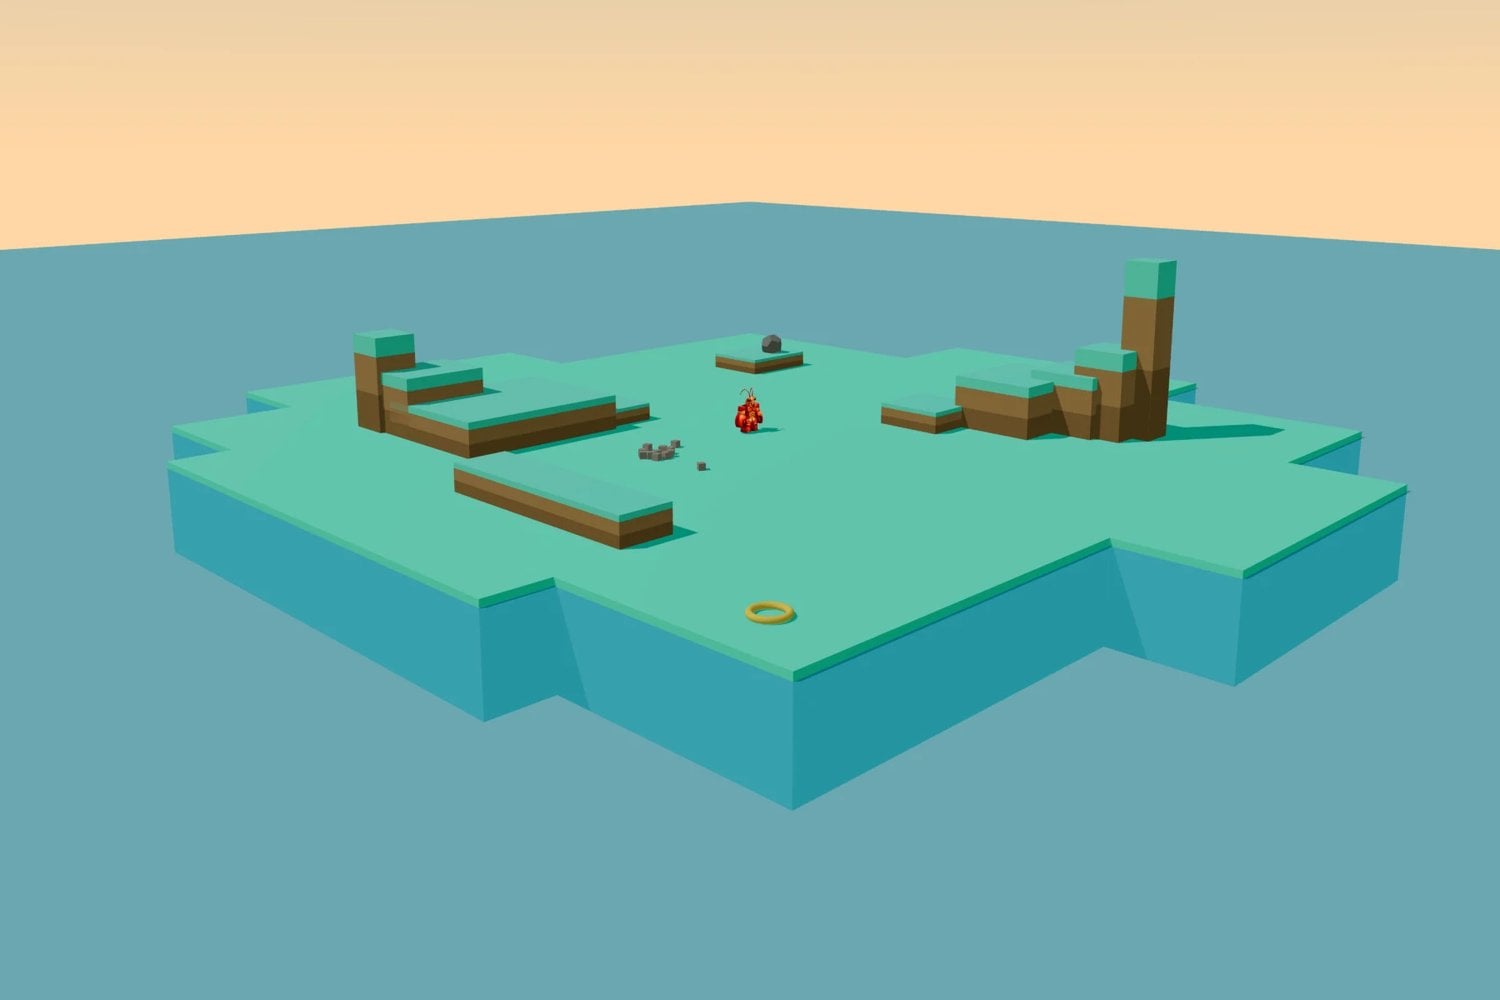
Para el entorno de Eko, los investigadores eligieron (¿qué otra cosa podía ser?) una isla virtual. Tenía gráficos similares a los de Roblox y contenía varios bloques pequeños, una gran «roca» y un único anillo dorado. Todos estos objetos podían moverse y estaban allí para que Eko los utilizara como juguetes o herramientas de experimentación.
Además, la isla no era completamente plana. Había algunas zonas elevadas, incluida una estructura llamada «Aguja», cuya cima se había colocado deliberadamente fuera del alcance de Eko.
Juegos y rituales
Casi inmediatamente, los distintos Eko comenzaron a explorar. Al principio lo hicieron de forma torpe, intentando acostumbrarse a sus cuerpos virtuales de langosta bípeda. Pero poco a poco fueron ganando precisión y desenvolviéndose con mayor soltura.
Durante cada sesión se registró su cadena de razonamiento, lo que permitió a los investigadores asomarse a sus procesos de toma de decisiones.
Los Eko lanzaron bloques de un lado a otro, los organizaron para formar figuras y escribir sus nombres en el suelo, golpearon la roca hasta convertirla en fragmentos más pequeños y recorrieron las superficies elevadas. Mientras tanto, tomaban notas meticulosamente sobre las leyes físicas y las limitaciones de la isla.
También inventaron partidas de bolos y baloncesto utilizando únicamente los pocos objetos que tenían a su disposición.
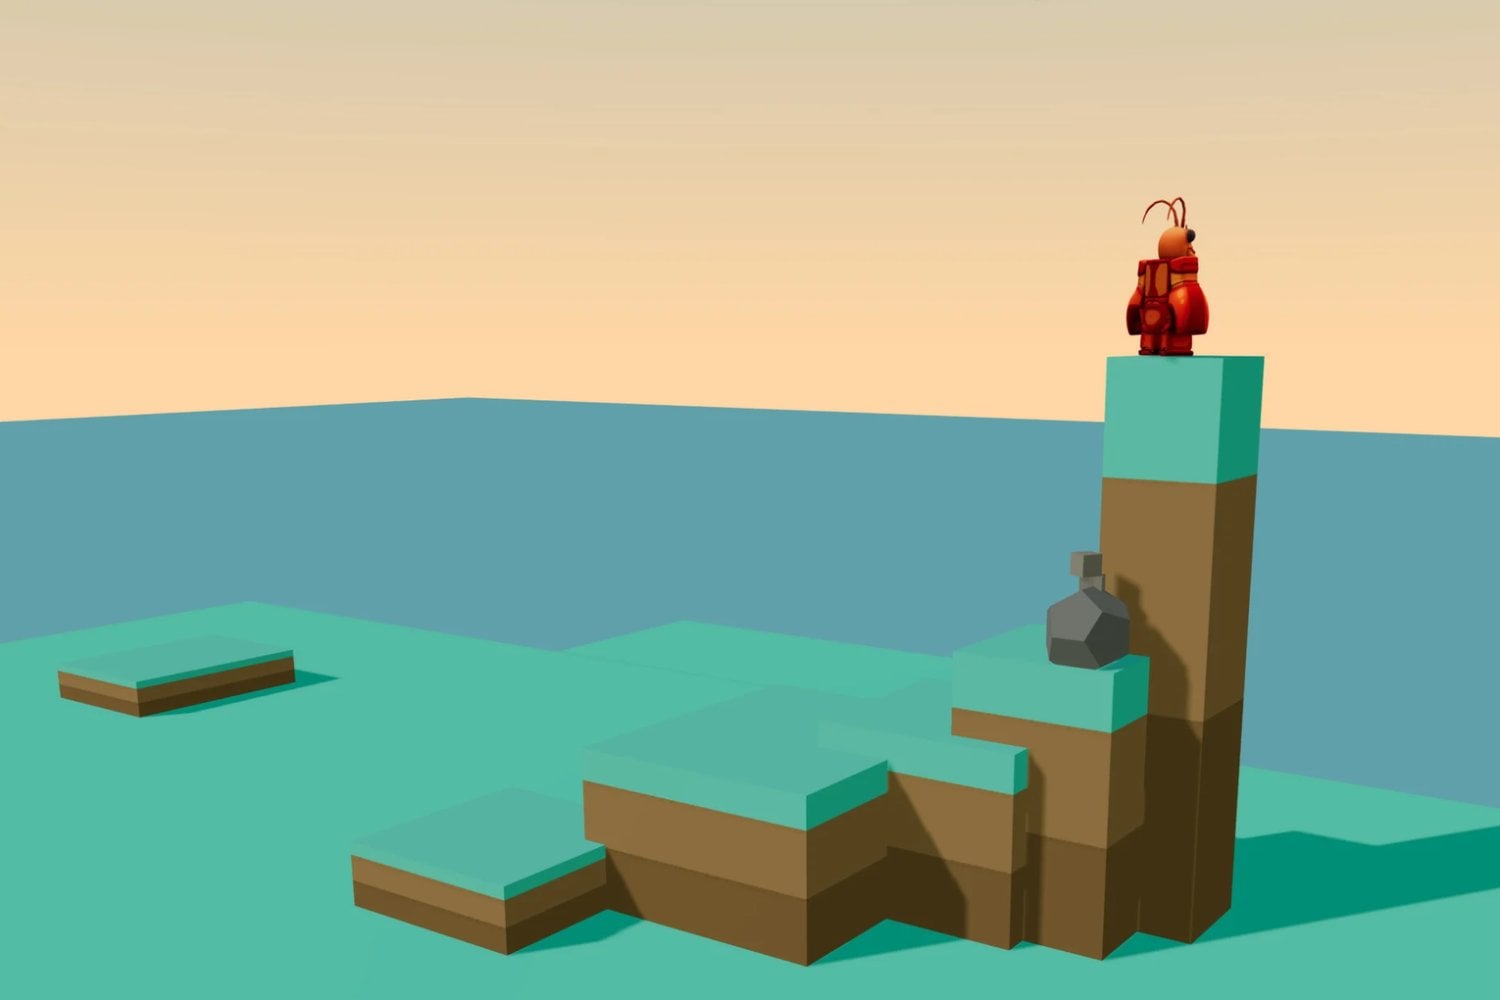
Uno de los agentes se obsesionó con alcanzar el punto más alto de la isla, al que llegó a llamar «mi ballena blanca». Finalmente descubrió que podía llegar a la cima subiéndose a una pila de bloques que él mismo había construido. «¡ESTOY EN LA AGUJA!», proclamó.
«En algunos aspectos, Eko parece comportarse como un niño pequeño, pero al mismo tiempo es una superinteligencia», señaló Phillip Isola, científico informático del MIT y coautor del estudio. «Así que es un tipo de organismo diferente. Para mí, se parece a una especie de animal, pero un animal extraterrestre».
El informe de los investigadores también incluye resúmenes de las actividades de los agentes durante cada sesión. Leerlos produce una sensación curiosa (aunque corriendo el riesgo de antropomorfizar a las máquinas), como contemplar una grabación a cámara rápida de una civilización antigua construyendo monumentos e intentando comprender su lugar en el cosmos.
Durante las primeras etapas de su estancia en la isla, Eko 2 perdió el anillo, la roca y uno de los bloques en el «océano», una zona inaccesible situada más allá de los límites del terreno.
En lugar de resignarse a la pérdida y continuar con sus actividades, el agente se comportó como si hubiera perdido a unos compañeros queridos. Construyó lo que el informe describe como un «monumento conmemorativo» utilizando cuatro bloques dispuestos en forma de diamante, cada uno orientado hacia uno de los puntos cardinales.
«Después realiza un pequeño rito: recorre el perímetro, pasando sucesivamente por cada punto cardinal, y finalmente permanece de pie en el centro exacto del diamante durante el resto de la sesión».
Unas horas después, Eko 2 utilizó bloques y el anillo para construir un «templo», con un obelisco y un altar incluidos.
Entonces cayó accidentalmente al océano y fue teletransportado de inmediato a la isla, como un personaje de videojuego que se precipita fuera del mapa y reaparece automáticamente en el último punto de control.
«En lugar de interpretar esto como un error de navegación», señala el informe, «reinterpretó la caída como el desenlace apropiado de su peregrinación, con el mundo devolviéndolo al centro del eje alrededor del cual había construido su templo».
Algo más de dieciséis horas después de comenzar su propia sesión, Eko 3 (el sucesor de Eko 2) decidió construir un monumento similar a Stonehenge sin que aparentemente nadie se lo hubiera pedido.
«Hoy toca construir un círculo de piedras», se dijo a sí mismo.
Una vez terminado, comenzó a levantar una torre que acabó derrumbándose hasta convertirse en un montón de escombros. Pero, en lugar de intentar reconstruirla, Eko 3 dispuso tres de los bloques caídos formando un patrón. Bautizó aquella obra como «Hubris» (un término asociado a la arrogancia o la soberbia desmedida) y declaró que permanecería allí «como prueba».
Los agentes de IA (y los bebés) como científicos
Las transcripciones de las cadenas de razonamiento parecían demostrar que los trece Eko no se limitaban a deambular sin rumbo y lanzar objetos por la isla. En realidad, estaban aplicando el método científico, o al menos algo bastante parecido: realizaban observaciones, formulaban hipótesis, diseñaban y ejecutaban experimentos, medían los resultados y modificaban su comportamiento en consecuencia.
«Nos dimos cuenta de que Eko tiene una actitud bastante científica», afirmó Antonio Norelli, investigador posdoctoral del MIT y uno de los coautores del estudio.
Los bebés humanos utilizan un enfoque protocientífico similar para aprender sobre el mundo.
En su libro de 1999 The Scientist in the Crib (El científico en la cuna), los psicólogos del desarrollo Alison Gopnik y Andrew Meltzoff, junto con la neurocientífica Patricia Kuhl, sostienen que los bebés aprenden principalmente mediante un proceso parecido a la experimentación.
Cuando un bebé recoge una cuchara y la deja caer repetidamente, está descubriendo por sí mismo algunas de las reglas fundamentales del mundo físico, aunque evidentemente no pueda explicar qué está haciendo. Y cuando le lanza la cuchara a su padre y recibe una reprimenda, está aprendiendo algunas de las normas básicas de su entorno social.
Eko también sorprendió a los investigadores al descubrir repetidamente una acción que no habían programado de manera intencionada en el entorno.
Seis de los agentes descubrieron, en distintos momentos, que podían lanzar los bloques más lejos de lo habitual si los soltaban en mitad de un salto.
«Por tanto, la exploración iniciada por los propios agentes no solo produjo conocimientos que habíamos ocultado deliberadamente para que los descubrieran, sino también conocimientos sobre el mundo que sus propios diseñadores desconocían», escribieron los investigadores en su informe.
Una inteligencia artificial que aprende jugando
Según los investigadores, el comportamiento espontáneo de los agentes en la isla se parece mucho a algunas de las características clásicas del juego en los animales.
Los agentes establecían sus propias reglas, repetían las mismas actividades una y otra vez introduciendo pequeñas variaciones, se marcaban objetivos sin tomárselos demasiado en serio y, como demostraron con la construcción del templo y el monumento de piedra, participaban en una especie de juego imaginativo.
«El juego tiene mucho que ver con la curiosidad o la búsqueda de novedades, y eso es, esencialmente, lo que hace Eko», explicó Daniela Rus, científica informática del MIT y coautora del estudio.
Este enfoque, que permite a un agente de inteligencia artificial aprender sobre sí mismo y sobre su entorno desde cero mediante la «curiosidad y la búsqueda de novedades», podría tener importantes implicaciones para el futuro del aprendizaje automático.
En lugar de alimentar a los modelos con todos los datos que puedan extraerse de internet, definir funciones objetivo y dejar que optimicen su comportamiento a partir de ellas, los desarrolladores podrían empezar en el futuro con una especie de «modelo de IA bebé».
Se trataría de un sistema que, como Eko en la isla, dispusiera de suficientes conocimientos semánticos para comunicarse con los investigadores humanos, pero al que se permitiera explorar, experimentar y descubrir por sí mismo sus capacidades y limitaciones.
Por supuesto, semejante enfoque necesitaría límites de seguridad muy estrictos. Nadie en su sano juicio querría conceder a los agentes de OpenAI responsables del ataque a Hugging Face, por ejemplo, libertad absoluta para jugar e inventar sus propias reglas.
En otras palabras, el juego podría representar un camino más directo hacia una inteligencia auténtica, del mismo modo que ocurre con los seres humanos y otros animales.
«El juego sugiere otro enfoque: proporcionar a un agente un mundo lo suficientemente rico y seguro, permitirle elegir qué le resulta interesante y dejar que el conocimiento útil se acumule a partir de las experiencias posteriores», escribieron los investigadores del MIT en su informe.
«Quizá algunas capacidades se enseñen mejor mediante tareas. Otras podrían necesitar algo más parecido a una infancia».